QA 팀이 아니라 Quality Platform 팀을 만든 이유
들어가며
품질을 맡는 팀이라고 하면 보통 QA 팀을 떠올립니다. 저희 팀도 처음에는 QA 팀처럼 일했습니다. 직접 QA를 하고, QA 역량을 키우는 로드맵을 세웠습니다. 2025년 여름부터 일하는 방식을 바꾸기 시작했습니다. 이때 시작한 프로젝트의 이름은 "Shift-left를 위한 엔지니어링 도구 만들기"였습니다. 결함을 찾는 시점을 개발 초기로 당기자는 뜻입니다.
개발 환경의 변화가 계기였습니다. 개발자들이 AI 에이전트와 함께 코드를 쓰기 시작하면서 개발 속도가 크게 빨라졌고, 품질을 다루는 방식도 그에 맞게 바꿔야 했습니다. 이번 글에서는 저희가 품질을 대신 확인하는 팀에서 만드는 사람이 품질을 직접 챙기도록 돕는 팀으로 방향을 바꾼 이유를 소개하겠습니다. 먼저 QA와 QC라는 말이 어디서 나왔는지 살펴보겠습니다.
QA와 QC라는 말은 공장에서 나왔습니다
QA(Quality Assurance, 품질 보증)와 QC(Quality Control, 품질 관리)는 원래 제조업에서 쓰던 말입니다. 같은 부품을 하루에 수만 개씩 만드는 공장에서는 모든 부품을 검사할 수 없습니다. 일부를 뽑아 검사하고, 불량률이 기준을 넘으면 그 묶음을 폐기하거나 라인을 멈춥니다. 이런 통계적 품질 관리는 1920년대 Bell 연구소에서 시작됐습니다. Walter Shewhart가 공정이 정상 범위에 있는지 그래프로 지켜보는 관리도를, Harold Dodge가 표본 검사 방식을 만들었습니다.
이 방식은 같은 물건을 반복해서 만들 때 효과가 있습니다. 설계는 이미 검증이 끝났고, 남은 위험은 생산 과정에서 생기는 편차뿐입니다. 그래서 만드는 사람과 검사하는 사람을 나눠도 됩니다.
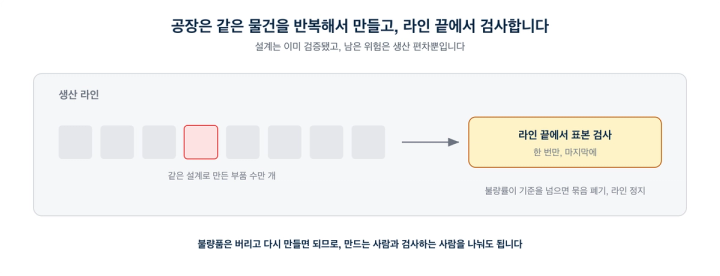
소프트웨어 조직은 이 용어를 받아들이면서 만드는 사람과 확인하는 사람을 나누는 방식도 도입했습니다. 개발자가 기능을 만들어 넘기면 QA 팀이 테스트하고, 결함이 나오면 티켓으로 돌려보냅니다. 저희는 이렇게 품질 확인을 다른 팀에 맡기는 구조를 품질의 외주화라고 봤습니다.
품질을 외주화하면 느려집니다
소프트웨어에서 같은 것을 여러 개 만드는 일은 복사입니다. 같은 빌드 결과물을 여러 환경에 배포해도 공장에서처럼 생산 편차가 생기지 않습니다. 개발자는 매번 새로운 기능을 만듭니다. 1992년에 Jack Reeves는 "What Is Software Design?"이라는 글에서 소스 코드는 생산품이 아니라 설계도이고, 개발은 처음부터 끝까지 설계라고 했습니다. 생산은 컴파일러가 거의 공짜로 해 주기 때문입니다. 소프트웨어의 결함은 개발자가 코드와 설정을 정하는 설계 과정에서 생깁니다.
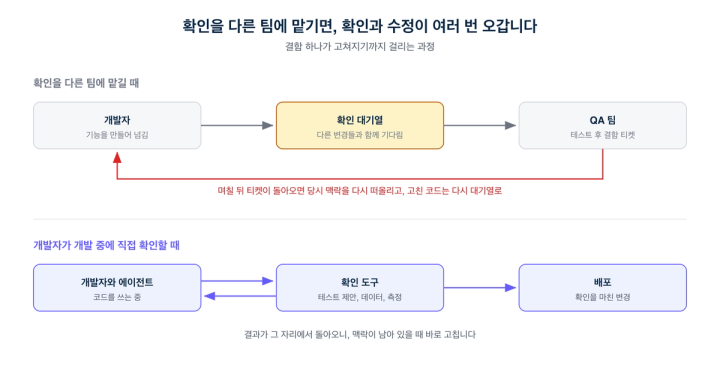
개발자가 코드를 쓰고 다른 사람이 결함을 확인하면, 코드와 피드백이 여러 번 오갑니다. 개발자는 기능을 넘기고 다음 일로 넘어갑니다. 며칠 뒤 결함 티켓을 받으면 당시의 맥락을 다시 떠올려야 합니다. 고친 코드는 다시 확인 대기열에 들어갑니다. 결함을 고치는 데 걸리는 시간뿐 아니라 확인을 기다리고 당시 맥락을 다시 파악하는 시간도 듭니다.
코드 변경이 많아지면 코드와 피드백이 오가는 횟수도 늘어납니다. 플렉스팀 GitHub 조직에 올라온 PR은 1년 사이 분기당 12,273건에서 30,765건으로 약 2.5배가 되었습니다. 에이전트 덕분에 코드를 만드는 비용은 크게 줄었습니다. 에이전트를 더 투입하면 코드 변경량은 늘어나지만, 확인할 사람을 채용하고 도메인을 익히게 하는 데는 몇 달이 걸립니다. 확인하는 사람을 늘려서 코드 변경량을 따라가는 방식은 이제 현실적이지 않습니다.
에이전트와 함께 일하면서 기능 하나를 설계하고 만들고 고치는 주기도 크게 줄었습니다. 이 주기 바깥에 확인 단계를 따로 두면, 개발자는 다른 팀의 확인이 끝날 때까지 기다려야 하고 확인이 주기 전체에서 가장 긴 구간이 됩니다. 확인도 개발 주기 안으로 들어와야 합니다.
품질과 성능은 개발할 때 챙겨야 합니다
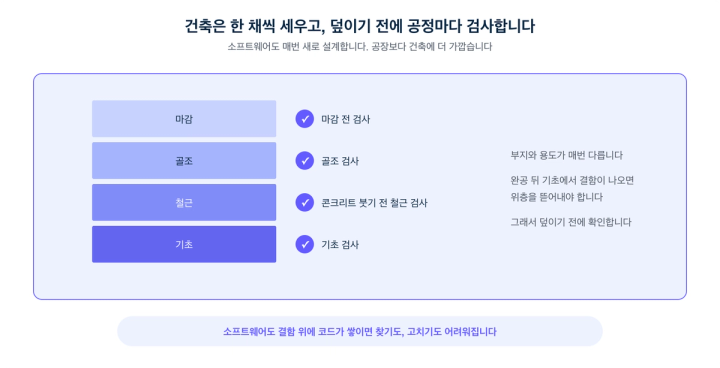
품질을 외주화하면 확인 시점도 늦어집니다. 저희는 소프트웨어가 공장보다 건축에 더 가깝다고 생각합니다. 건물은 한 채씩 세우고, 부지와 용도도 매번 다릅니다. 완공한 뒤 기초에서 결함을 발견하면 위층을 뜯어내야 합니다. 그래서 건축 현장에서는 콘크리트를 붓기 전에 철근이 제대로 놓였는지 검사합니다. 콘크리트가 굳으면 확인하기도 어렵고 고치기는 더 어렵기 때문입니다. 건축법이 주요 공정마다 감리자의 확인을 받게 하는 이유도 같습니다.
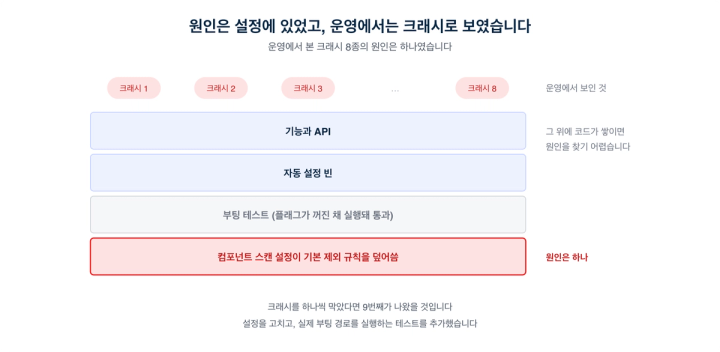
크래시 8종, 원인은 하나
저희 팀이 운영하는 시스템에서 실제로 이런 일이 있었습니다. 운영 환경에서 서로 다른 크래시 8종이 발생했습니다. 크래시를 일으킨 원인은 하나였습니다. 컴포넌트 스캔 설정이 Spring Boot의 기본 제외 규칙을 덮어썼고, 그 결과 자동 설정 빈이 등록되지 않았습니다. Spring Boot 자체에는 문제가 없었습니다. 저희가 컴포넌트 스캔을 설정한 방식 때문에 생긴 문제였습니다. 부팅 테스트는 해당 경로를 켜는 플래그가 꺼진 상태로 실행됐고, 그래서 통과했습니다.
운영 환경에서는 8종의 크래시가 나타났습니다. 원인은 개발 중에 정한 컴포넌트 스캔 설정이었습니다. 이 문제를 가장 먼저 알아차릴 수 있는 사람은 그 설정을 정한 개발자였습니다. 설정을 정할 때 실제 부팅 경로를 실행하는 테스트가 있었다면 배포 전에 문제를 발견했을 것입니다. 저희는 원인을 고치고 그 테스트를 추가했습니다.
성능도 개발하면서 확인할 수 있습니다
성능 문제도 개발할 때 생깁니다. 성능이라고 하면 부하 테스트를 먼저 떠올리기 쉽지만, 저희가 자주 겪은 문제는 그보다 앞에서 생겼습니다. 새 조회 조건을 추가하면서 그 조건에 맞는 인덱스를 만들지 않는 경우가 대표적입니다. 코드를 쓰는 사람이 이 테이블에 데이터가 얼마나 쌓이는지, 어떤 순서로 자주 읽히는지를 모르면 인덱스가 필요하다는 것도 알기 어렵습니다. 이런 시스템 요건은 문서보다 오래 일한 사람의 기억에 있는 경우가 많았습니다.
빈 개발 DB에서는 이 문제가 보이지 않습니다. 행이 몇 개뿐이라 인덱스가 없어도 쿼리가 금방 끝나고, 테스트도 통과합니다. 리뷰어가 기억해 내지 못하면 그대로 배포되고, 데이터가 많은 고객사에서 화면이 느려진 뒤에야 드러났습니다. 고객사와 비슷한 규모의 데이터를 준비하고, 실행 계획을 확인하고, 쿼리 수와 응답 시간을 재는 일은 손이 많이 가서 개발 중에는 미루기 쉬웠습니다.
AI 에이전트를 쓰면서 이 확인을 코드를 쓸 때마다 할 수 있게 됐습니다. 에이전트는 조회 코드를 고친 뒤 고객사 규모의 데이터로 쿼리를 실행하고, 실행 계획을 보고 전체 스캔이 생겼는지, 쿼리 수가 늘었는지를 확인합니다. 사람이 시스템 요건을 다 알지 못해도 빠진 인덱스를 배포 전에 찾을 수 있습니다. 부하 테스트까지 가지 않아도 개발 중에 성능 문제의 상당 부분을 걸러 낼 수 있습니다.
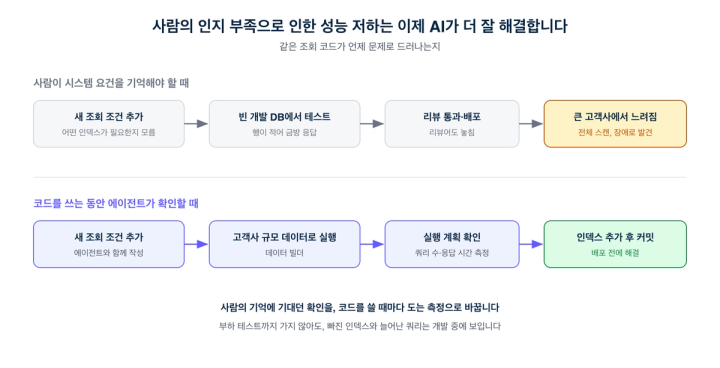
그러려면 에이전트와 개발자가 개발 중에 측정 결과를 볼 수 있어야 하고, 고객사와 비슷한 데이터로 테스트할 수 있어야 합니다. 뒤에서 소개할 데이터 빌더가 이 데이터를 만듭니다. 저희 팀은 2025년부터 개발자가 문제를 쉽게 확인하고 품질을 확인하는 데 드는 시간과 수고를 줄일 수 있는 환경을 만들기로 했습니다.
만드는 사람이 품질을 직접 확인하는 환경
그래서 저희 팀은 개발자가 품질을 직접 확인할 수 있는 환경과 도구를 만드는 데 집중하기로 했습니다. 지금 팀 목표도 "사람이 다시 확인하던 제품의 정답을 시스템으로 옮긴다"입니다.
개발자는 이미 CI/CD를 직접 다룹니다. 변경을 올리면 빌드와 테스트가 돌고, 통과하면 배포됩니다. CI가 돌리는 것은 개발자가 이미 쓴 테스트입니다. 그래서 CI만으로는 어떤 테스트가 빠졌는지, 고객사와 비슷한 데이터에서도 통과하는지까지는 알 수 없습니다. 민감정보를 마스킹했는지 같은 규칙도 리뷰하는 사람이 기억해야 했습니다. 저희가 채우려는 것은 이 부분입니다. 무엇을 확인해야 하는지와 확인에 필요한 재료를, 개발자가 코드를 쓰는 순간부터 쓸 수 있게 만듭니다.
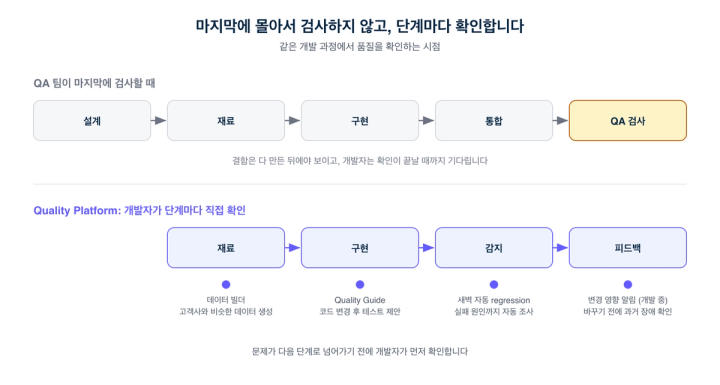
개발 과정을 설계, 재료, 환경, 실행, 감지, 피드백 루프, 가시화로 나누고, 단계마다 만드는 사람이 직접 쓰는 도구를 하나씩 만들고 있습니다. 대표적인 도구 몇 가지를 소개하겠습니다.
구현 단계: Quality Guide
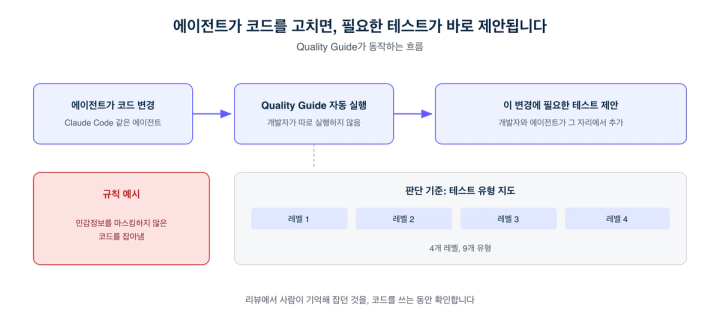
Quality Guide는 개발자의 코드 작성 과정에서 동작합니다. Claude Code 같은 에이전트가 코드 변경을 마치면 Quality Guide가 자동으로 실행되어 필요한 테스트를 제안합니다. 테스트는 4개 레벨, 9개 유형으로 나눠 두었습니다. 개발자가 따로 실행할 필요는 없습니다.
민감정보 마스킹처럼 리뷰하는 사람이 기억해서 잡던 규칙도 Quality Guide에 넣었습니다. 리뷰어가 떠올리지 못해도 코드를 쓰는 동안 자동으로 검사됩니다.
테스트 데이터: 데이터 빌더
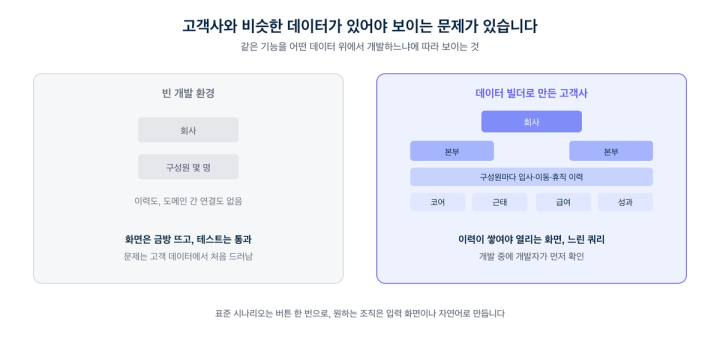
HR 제품에는 데이터가 쌓여야 드러나는 결함과 성능 문제가 많습니다. 조직이 여러 단계로 나뉘고, 구성원마다 입사·이동·휴직 이력이 쌓이고, 근태·급여·성과 데이터가 서로 연결되어야 재현됩니다. 빈 개발 환경에서는 이런 문제가 보이지 않습니다.
데이터 빌더를 쓰면 만드는 사람이 이런 고객사 데이터를 직접 만들 수 있습니다. 표준 시나리오는 버튼 한 번으로 생성할 수 있고, 커스텀 빌더에서는 입력 화면이나 자연어로 원하는 조직과 데이터를 정의해 만들 수 있습니다. 데이터 빌더는 코어, 근태, 급여, 성과 4개 도메인의 데이터를 한 고객사 안에서 서로 연결해 생성합니다.
이 데이터가 있으면 개발 중에 더 많은 조건을 확인할 수 있습니다. 연말정산처럼 1년 치 이력이 쌓여야 열리는 화면을 바로 열어 볼 수 있고, 조직 개편 같은 기능을 실제와 비슷한 조직 데이터로 실행해 볼 수 있습니다. 고객사와 비슷한 데이터로 기능을 만들면 느린 쿼리를 고객보다 먼저 확인할 수 있습니다. 테스트 데이터를 다른 팀에 요청하고 기다릴 필요도 없습니다. 저희는 빌더를 매시간 자동으로 실행해 언제든 사용할 수 있는 상태인지 확인합니다.
전체 사용자 흐름 확인: 자동 regression
개발 단계에서 쓰는 도구와 별도로 전체 사용자 흐름을 확인하는 자동 regression 테스트도 운영합니다. 4개 도메인의 API·E2E regression 테스트가 평일 새벽에 자동으로 실행되고, 테스트가 실패하면 원인 분류와 관련 코드 조사까지 자동으로 진행됩니다. 개발자는 출근하면 실패한 테스트와 확인할 항목을 바로 볼 수 있습니다. 지금은 "이 API를 바꾸면 예전에 무엇이 깨졌는지"를 변경 전에 알려 주는 기능을 만들고 있습니다.
마치며
Cloud Platform 팀이 인프라 요청을 대신 처리하지 않고 개발자가 직접 쓸 수 있는 도구를 만드는 것처럼, Quality Platform 팀은 품질을 대신 확인하지 않고 만드는 사람이 직접 챙길 수 있는 도구를 만듭니다. 팀 이름에서 Assurance를 빼고 Platform을 넣은 이유도 여기에 있습니다. 에이전트로 코드 변경이 많아진 만큼 품질과 성능은 개발하는 동안 확인해야 합니다. 저희는 이 확인을 개인의 꼼꼼함에 맡기지 않고 도구로 돕습니다.
현재 저희는 이 일을 함께 이끌어 갈 Quality Platform Lead를 찾고 있습니다. 이 플랫폼을 쓰는 사람은 제품 엔지니어입니다. 어느 단계에서 무엇을 확인해야 하는지는 기능을 직접 개발해 본 사람이 가장 잘 압니다. 제품 엔지니어링 경험이 있는 분이면 더욱 좋습니다. 결함을 직접 찾는 것보다 만드는 사람이 결함을 일찍 알아차릴 수 있도록 개발 환경을 개선하는 데 관심이 있으시다면 플렉스팀 채용 페이지에서 공고를 확인해 주세요.
긴 글 읽어 주셔서 감사합니다.
🚀플렉스팀 채용페이지 바로가기
☕flex Private Talk 신청하기